AI ENGINEER / 모성우

SELECTED WORKS — 2026

THE PROJECT ROOM

대답하는 모델을, 실행하는 시스템으로.

Qwen3-8B · Tool Calling

원리를 이해하고,
현실에서 작동하게 만듭니다.

로컬 LLM의 도구 실행부터 추론 최적화까지.
아이디어를 구현하고, 실험으로 검증합니다.

프로젝트 살펴보기

01 / SELECTED WORK

Selected work(04)

아이디어를 구현으로.
결과를 다음 선택의 근거로.

01 AGENTIC AI / LOCAL LLM

Reny.

대답하는 모델을,
실행하는 시스템으로.

Qwen3-8B의 판단을 macOS 제어·웹 검색·메신저에 연결했습니다. 실행 결과가 다시 모델의 응답으로 이어지도록 에이전트 흐름을 구성했습니다.

핵심 결정

모델의 답변과 도구의 실행 결과를
하나의 흐름으로 연결하기.

Qwen3-8B / LM Studio / Tool Calling

01 / ACTUAL EXECUTION

요청이 실제 시스템 제어로 이어지는 순간.
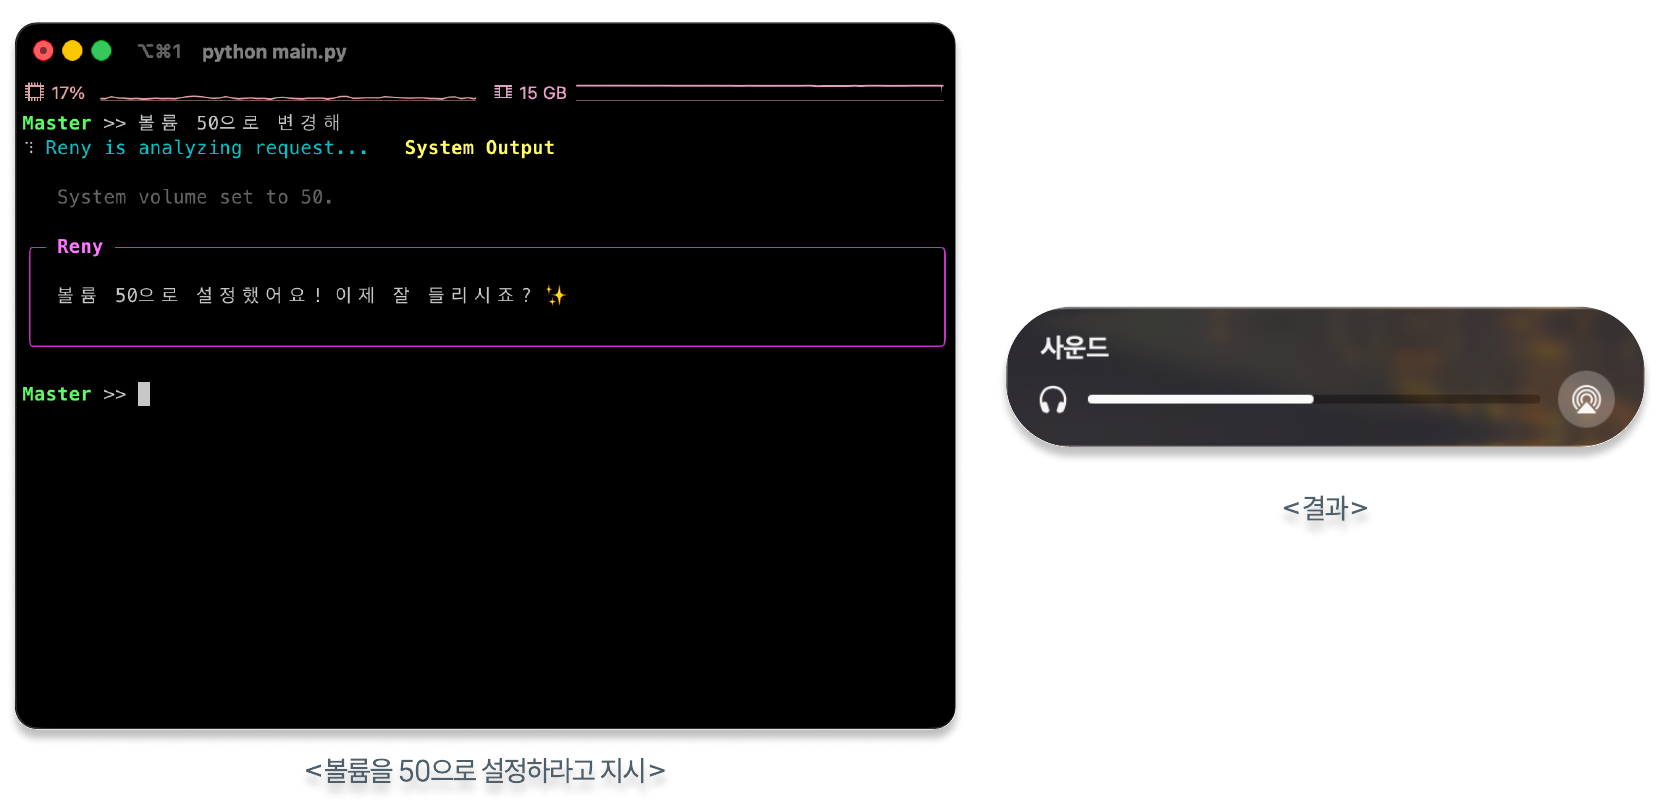
Reny 대화창의 볼륨 변경 요청, 시스템 볼륨을 50으로 설정한 도구 실행 결과와 macOS 볼륨 표시이미지 크게 보기
볼륨 변경 요청 → 도구 실행 → 결과 확인

“볼륨을 50으로 변경해”라는 요청과 실행 로그, macOS의 볼륨 변화를 한 화면에서 확인할 수 있습니다.

RENY / EXECUTION FLOW
01 / REQUEST

자연어로 요청한 작업에서 실행 흐름이 시작됩니다.

01 / USER INPUT

“볼륨을 50으로 변경해.”

02 / REASONQwen3-8B요청 이해 · 도구 선택
03 / ACTmacOS 제어
TOOL웹 검색
TOOL메신저
04 / OBSERVESystem volume set to 50.

요청에서 실행 결과까지 이어지는 에이전트 흐름

02 LLM OPTIMIZATION

더 높은 점수.
더 짧은 추론.

LG Aimers 8기에서 EXAONE-4.0-1.2B의 양자화 설정과 calibration, vLLM 호환성을 함께 조정했습니다.

25.3% ↓

추론 시간 감소
14분 22초 → 10분 44초

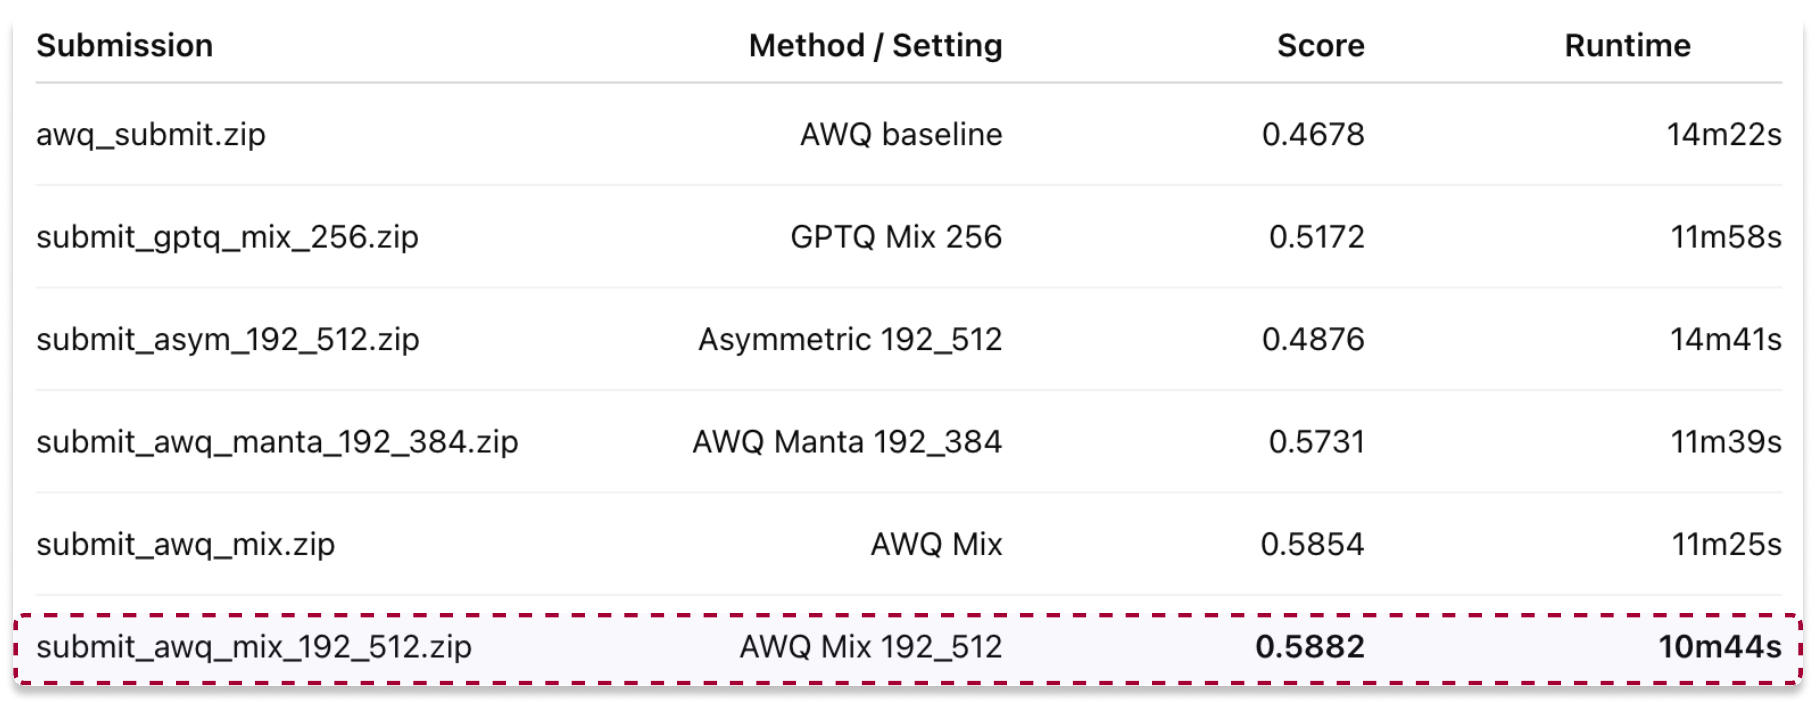
대회 평가 점수 0.4678 → 0.5882

02 / SUBMISSION RESULTS

여섯 번의 제출, 직접 비교한 결과.

여섯 양자화 설정의 실제 제출 기록. AWQ baseline의 점수 0.4678과 시간 14분 22초, AWQ Mix 192_512의 점수 0.5882와 시간 10분 44초이미지 크게 보기
최종 선택: AWQ Mix 192_512

기준 설정 대비 대회 평가 점수는 0.4678에서 0.5882로, 추론 시간은 14분 22초에서 10분 44초로 바뀌었습니다. 아래 그래프에서 지표별로 비교할 수 있습니다.

EXPERIMENT LOG / 06 RUNS

같은 환경, 다른 설정.

AWQ baseline14m 22s
GPTQ Mix 25611m 58s
Asymmetric 192_51214m 41s
AWQ Manta 192_38411m 39s
AWQ Mix11m 25s
AWQ Mix 192_512 최종 선택10m 44s

추론 시간은 짧을수록 좋습니다. 대회 평가 환경의 제출 결과.

WHY THIS SETTING?

단일 기법의 우위보다,
점수·추론 시간·호환성의 균형.

03 EXPLAINABLE AI

Medical XAI 개인 프로젝트

모델이 배경을 보고 있었다.
그래서, 입력부터 다시.

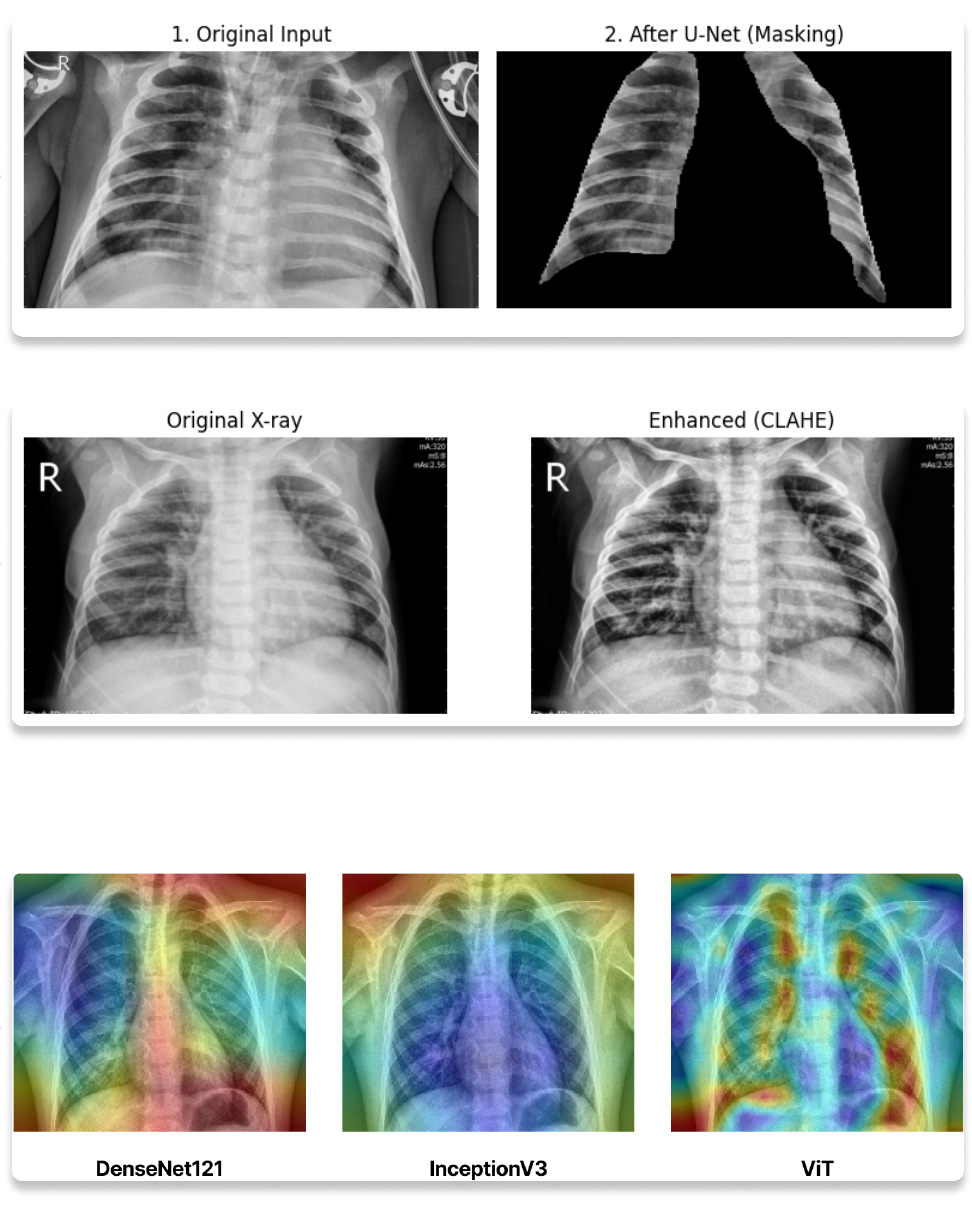
Grad-CAM의 관찰에서 출발해 U-Net 폐 영역 분할과 CLAHE 전처리를 결합했습니다.

관찰 지름길 학습 양상 결정 파이프라인 재설계
  1. 01
    폐 영역을 분리하다.

    원본 영상과 U-Net 마스킹 결과

  2. 02
    입력의 대비를 보강하다.

    CLAHE 적용 전후의 영상

  3. 03
    모델이 보는 곳을 비교하다.

    DenseNet121 · InceptionV3 · ViT

03 / IMAGE PIPELINE

입력 영상부터 모델의 판단 영역까지.

위: 원본 흉부 X선과 U-Net 폐 영역 분할. 가운데: 원본과 CLAHE 전처리 영상. 아래: DenseNet121, InceptionV3, ViT의 판단 영역 비교이미지 크게 보기
위에서부터 분할 → 전처리 → 판단 영역 비교

U-Net으로 폐 영역을 분리하고 CLAHE로 대비를 보강한 영상, 세 모델의 판단 영역을 함께 보여줍니다. 파이프라인의 구성과 관찰 결과를 확인하는 이미지입니다.

04 COMPUTER VISION

도로 객체 탐지 팀장 · 팀 프로젝트

3,527장의 데이터에서,
모델 선택의 근거를 찾다.

주행 맥락에 맞는 12개 클래스를 설계하고, YOLOv8과 DETR을 비교해 최종 모델을 선택했습니다.

비교 YOLOv8 · DETR 선택 YOLOv8
3,527학습 데이터 이미지
12탐지 클래스
04 / DETECTION RESULT

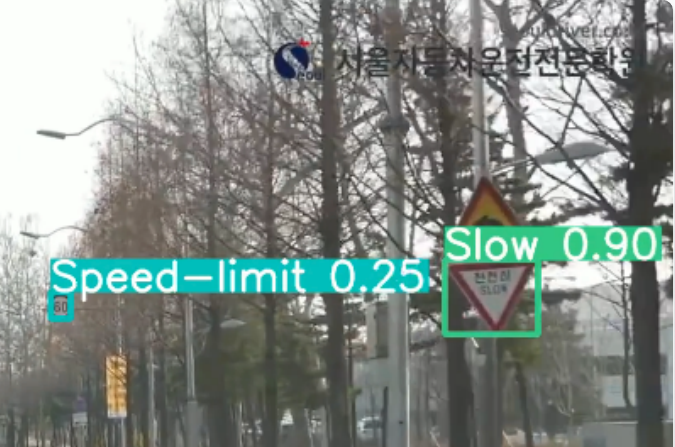
도로 위에서 확인한 표지판 탐지.

도로 주행 영상에서 속도 제한 표지판에 0.25, 서행 표지판에 0.90의 탐지 신뢰도가 표시된 화면이미지 크게 보기
속도 제한·서행 표지판의 탐지 위치와 신뢰도

박스 위의 0.25와 0.90은 이 장면에서 각 탐지의 신뢰도입니다. 전체 데이터셋의 정확도나 mAP를 뜻하지 않습니다.

02 / ABOUT ME

단단한 기초 위에,
새로운 문제를 해결합니다.

안녕하세요, 모성우입니다.
모델의 원리를 이해하는 데서 멈추지 않고,
직접 구현하고 검증하며 역량을 쌓아왔습니다.

AI를 활용해 업무의 비효율을 찾고,
실제로 사용할 수 있는 시스템을 만드는 일에
기여하고 싶습니다.

자기소개 더 읽기
01

아이디어를, 실행 가능한 흐름으로.

Reny에서 LLM의 판단과 도구 실행을 연결했습니다. 모델의 답변이 실제 컴퓨터에서 수행되는 작업으로 이어지도록 구성했습니다.

Reny의 구현 과정
02

선택의 근거는, 실험에서.

경량화 기법의 이름보다 제출 환경에서의 결과를 비교했습니다. 평가 점수, 추론 시간, 호환성을 함께 고려해 최종 설정을 선택했습니다.

LLM 최적화의 선택 기준
03

예상과 다르면, 구조를 다시.

XAI 실험에서 모델이 배경에 의존하는 양상을 확인했습니다. 데이터와 판단 영역을 살펴보고 분할·전처리 흐름을 다시 설계했습니다.

모델을 다시 설계한 이유

03 / CAPABILITIES & EXPERIENCE

프로젝트로 쌓아온 기반.

LLM & Agent

Qwen3 · LM Studio
Tool Calling · Agent Workflow
macOS 제어 · 검색·메신저 연동

Optimization

AWQ · GPTQ · Mixed Precision
Calibration · vLLM
원격 GPU 실험 · 제출 환경 검증

Computer Vision

YOLOv8 · DETR · U-Net
DenseNet121 · InceptionV3 · ViT
Grad-CAM · Attention Map · CLAHE

학습·프로젝트

중부대학교 AI 프로젝트 팀장 / 개인 프로젝트 경험

교육

LG Aimers 8기 수료 LLM 경량화 실험 및 평가

수상

캡스톤 디자인 대회 장려상 중부대학교 · 2023

자격

IoT지식능력검정 자격 취득

04 / SELF-INTRODUCTION

SEONGWOO MO / AI ENGINEER

단단한 기초 위에,
성장을 이어갑니다.

자기소개 읽기

새로운 기술을 배우고, 복잡한 문제를 구조화하며,
변화에 유연하게 적응합니다.
직접 만들고 검증하며 쌓아온 제 이야기를 소개합니다.

SEONGWOO MO / SELECTED WORK